同一段视频,问题不同,真正有用的信息也不同。询问车辆位置时,画面是重点;询问女性声音出现次数时,音频更关键;判断整体氛围时,则需要综合视听线索。
视频帧和音频片段会被编码成大量 token。输入越长,注意力计算与显存开销越高;重复画面和无关声音还会消耗额外算力。行业需要的不是简单删减输入,而是根据问题留下决定答案的关键信息。
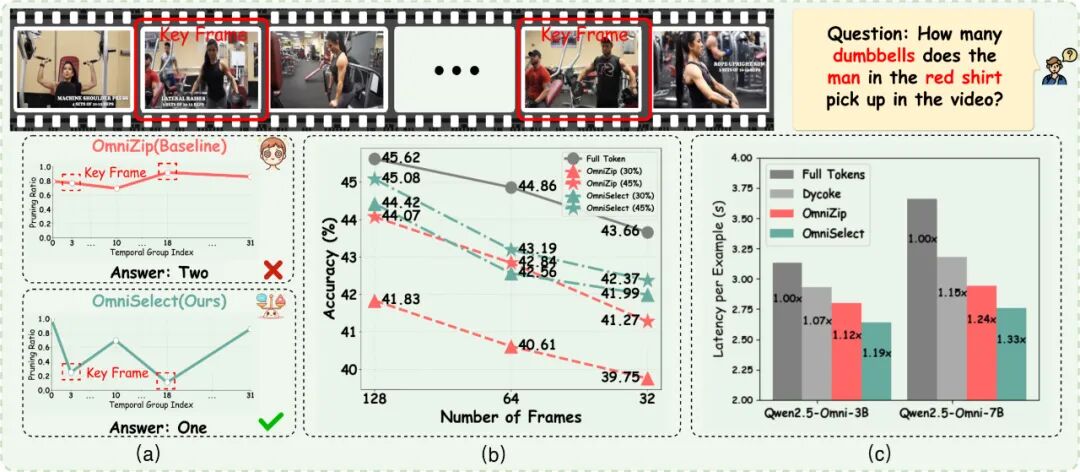
图1 OmniSelect 通过动态 token 剪枝降低计算开销
基于这一需求,是石科技与苏州大学、北京大学相关研究者共同提出 OmniSelect:估计问题与视觉、音频的相关性并选择剪枝策略,再在各模态预设的总剪枝预算内,为选定模态的不同时间组动态分配剪枝比例,最后在组内筛选 token。在移除 70% 音视频 token 的实验设置下,OmniSelect 实现了 1.19 至 1.33 倍的整体推理加速,同时尽可能保持模型理解能力。
同一段视频,为什么需要不同的剪枝策略
始终由固定的音频或视觉模态引导剪枝,可能忽略不同问题对视听信息的依赖差异,从而删掉回答所需的信息。因此,全模态推理的效率问题,实质上是信息选择问题:模型能否先理解“用户在问什么”,再决定“哪些内容值得关注”。这也是 OmniSelect 的出发点。
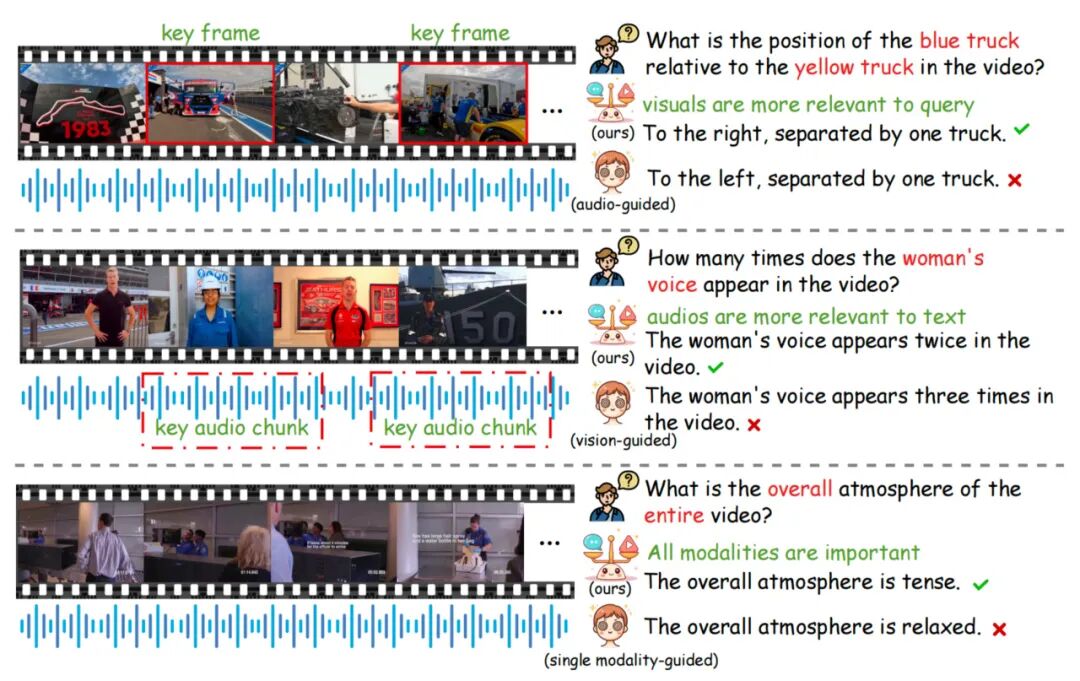
图2 不同问题对应不同的视觉与音频信息需求
先判断模态 再精细剪枝
01 判断采用哪种剪枝策略
OmniSelect 是一种无需额外训练的模态自适应剪枝框架。它借助 AudioCLIP 将文本、视觉和音频映射到共享表示空间,通过模态间相似度估计视觉与音频对问题的重要性,再选择以视频为中心、以音频为中心或均匀剪枝。为控制额外开销,方法还对视频帧进行降采样,并通过轻量词性过滤保留问题中的名词和形容词。
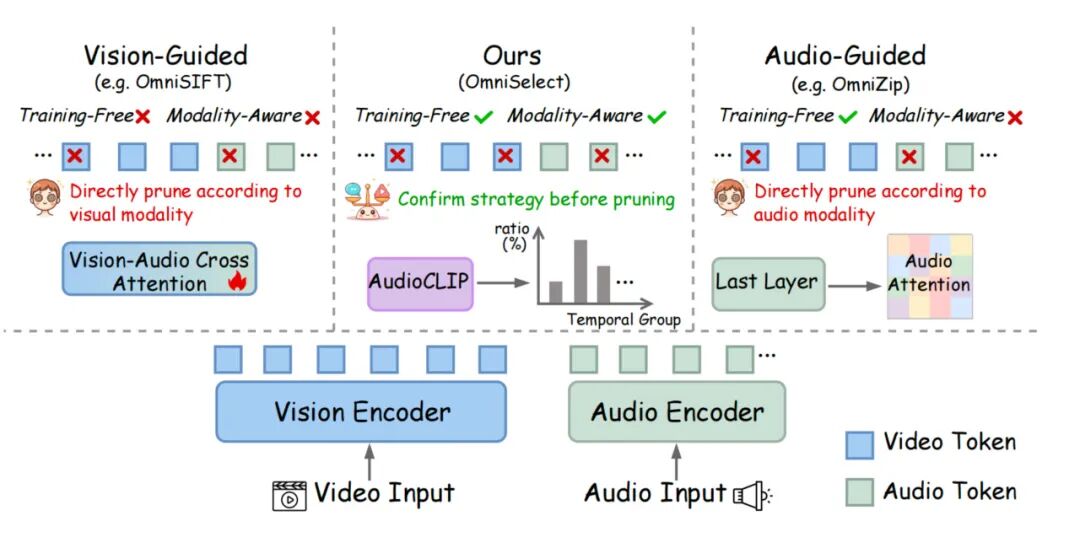
图3 OmniSelect 根据问题动态选择剪枝策略和现有Token压缩方法对比
02 分配不同时间组的剪枝比例
完成模态判断后,OmniSelect 将视频帧与对应音频片段组织成时间组。与问题更相关的模态会按时间组的重要程度动态分配剪枝比例:相关片段少剪,弱相关片段多剪;框架依据两种模态与问题的相关性分数及设定的阈值规则,选择以视频为中心、以音频为中心或均匀剪枝;在模态中心策略下,对选定模态按时间组分配剪枝比例,另一模态采用均匀比例。
03 筛选时间组内的 token
音频侧利用编码器最后一层的注意力,经池化对齐并计算平均注意力得分后保留 Top-K token;视觉侧计算时间组内各 token 与其他 token 的平均余弦相似度,保留平均相似度最低的 Bottom-K token,以减少冗余。两种规则分别适配音频和视觉特征,共同把有限计算留给更可能影响答案的内容。
下面的流程图展示了这两个阶段:可以先看比例分配,再看时间组内的 token 筛选。
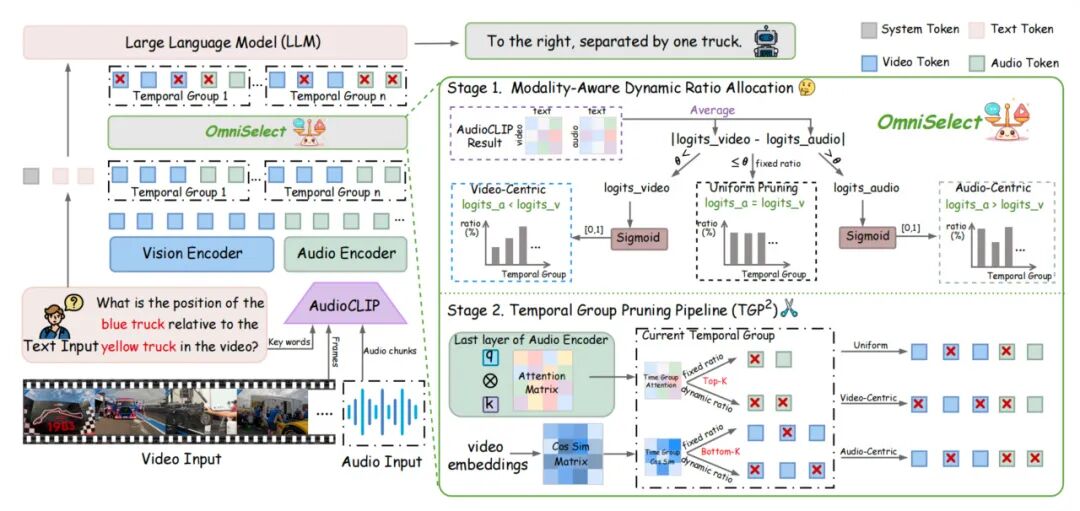
图4 OmniSelect 包含模态感知比例分配与时间组精细剪枝两个阶段
实测提升效率并保留大部分准确率
论文在 Qwen2.5-Omni 3B 和 7B 模型上评估,评测基准覆盖 WorldSense、DailyOmni、含音频的 VideoMME 和 OmniVideoBench,并与 OmniZip (CVPR 2026)、随机剪枝及适配音视频输入的 DyCoke (CVPR 2025) 比较。
01 推理延迟
在 WorldSense 评测基准上,采样128 帧设置下,仅保留 30% 音视频 token 时,3B 模型平均推理延迟由 3.13 秒降至 2.64 秒,7B 模型由 3.66 秒降至 2.76 秒,整体速度分别达到完整 token 基准的 1.19 倍和 1.33 倍(计时已包含 AudioCLIP 与剪枝等方法特有开销,公共的数据加载与预处理耗时未计入,例如我们测试了在WorldSense评测基准上,AudioCLIP平均处理时间是0.191秒)。
02 预填充与显存
输入预填充阶段,3B 模型平均时间由 594 毫秒降至 164 毫秒,7B 模型由 1119 毫秒降至 317 毫秒,分别约为 3.62 倍和 3.53 倍加速。峰值显存则由 15.08 GB 降至 12.47 GB、由 25.08 GB 降至 22.28 GB。预填充加速与整体推理加速是不同指标,不能混用。
03 准确率表现
在准确率方面,同一设置下 OmniSelect 分别达到 44.42% 和 44.17%,相当于完整 token 基准的约 97.4% 和 94.3%,也高于相同保留比例下 OmniZip 的 41.83% 和 43.85%。
3B 模型在 OmniVideoBench 上的得分还由完整输入的 32.9 小幅升至 33.3。该结果说明减少冗余有时可能帮助模型聚焦,但不代表压缩会在所有任务中提高准确率。
为分析动态策略选择的潜力,我们还进一步做了Oracle 实验,根据每个样本在不同剪枝策略下的表现选择最优策略。结果表明,在相同的 token 保留率下,Oracle 在多个设置中超过了 Full-token 基线(见图5)。这说明输入中存在可安全移除的冗余信息,合理的 token 压缩不仅能够降低计算开销,还可能减少无关信息干扰并提升模型性能。
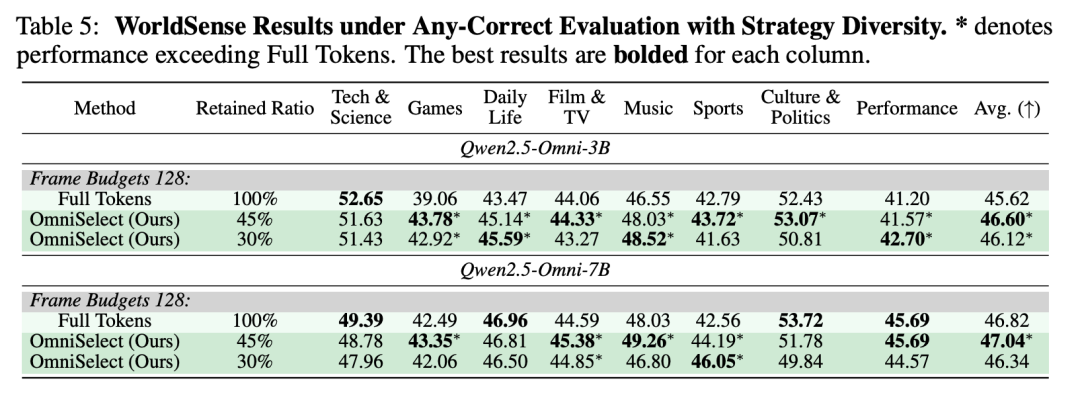
图5 OmniSelect 的Oracle实验结果
OmniSelect的具体可视化结果
为进一步直观展示 OmniSelect 的压缩效果,我们可视化了一个典型样例中的 token 保留结果。如图6所示,加黑色阴影的位置代表该位置的视觉token被移除不参与后续语言模型的计算,OmniSelect 能够根据当前输入动态保留与问题相关的音频和视频 token,同时去除大量时序冗余或语义贡献较低的 token。保留后的 token 仍覆盖了回答问题所需的关键信息,说明 OmniSelect 能在显著减少 token 数量的同时维持有效的多模态语义表示。
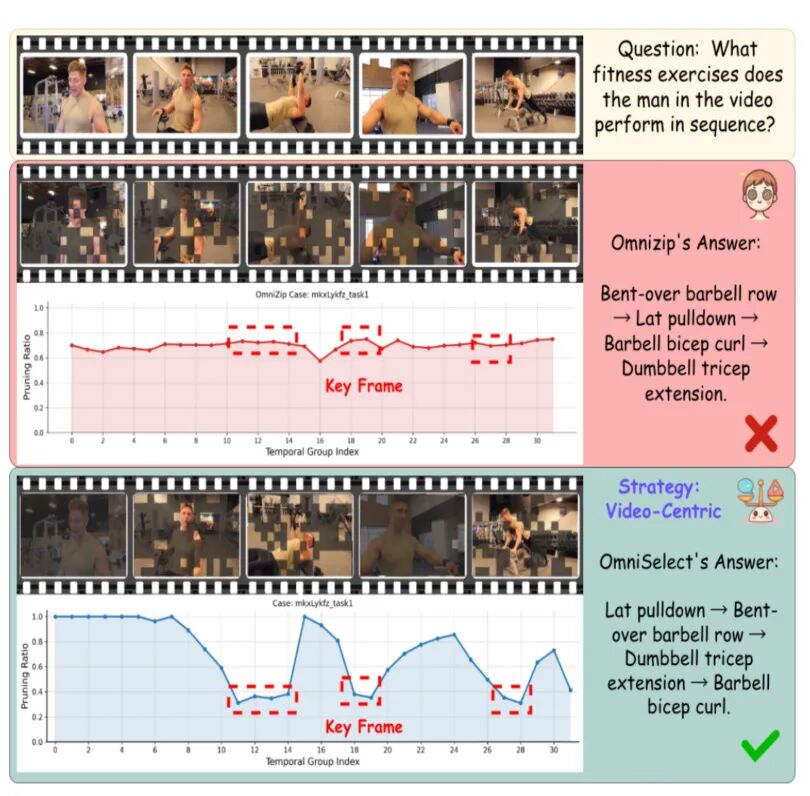
图6 OmniSelect 的 token 压缩案例
这项研究对实际应用意味着什么
围绕音视频理解中的效率需求,OmniSelect 提供了一条更贴近应用的优化路径:无需额外训练,在进入大语言模型主干前,根据问题压缩音视频 token。对于视频问答、内容检索等应用,这一思路有望缩短等待、缓解显存压力,并为更长视频或更高并发创造空间。
实际收益仍会受到模型架构、输入长度、硬件环境和任务特点影响,论文中的加速倍数应放在对应实验条件下理解。这项研究也带来一个启发:多模态系统不应只追求接收更多信息,还应学习识别哪些信息与当前任务真正相关。
在这项联合研究中,是石科技与高校研究者尝试了一条具体路径:从问题识别关键模态,再沿时间轴定位关键片段,最后用适合各模态的规则筛选 token。目标是让模型在看懂画面、听懂声音的同时,把计算资源用得更有效。这套思路也为同类模型的效率优化提供了参考。
论文链接:https://arxiv.org/pdf/2605.18041
代码链接:
https://github.com/Yangmrl-nlp/OmniSelec