2026 年 11 月 15 日,第八届中国超级算力大会(ChinaSC 2026)在北京隆重举行。本届大会以“智算力,大模型,新经济”为主题,汇聚政策、学术与产业三方力量,围绕算力基建创新、大模型场景落地与经济形态进化展开深入研讨。
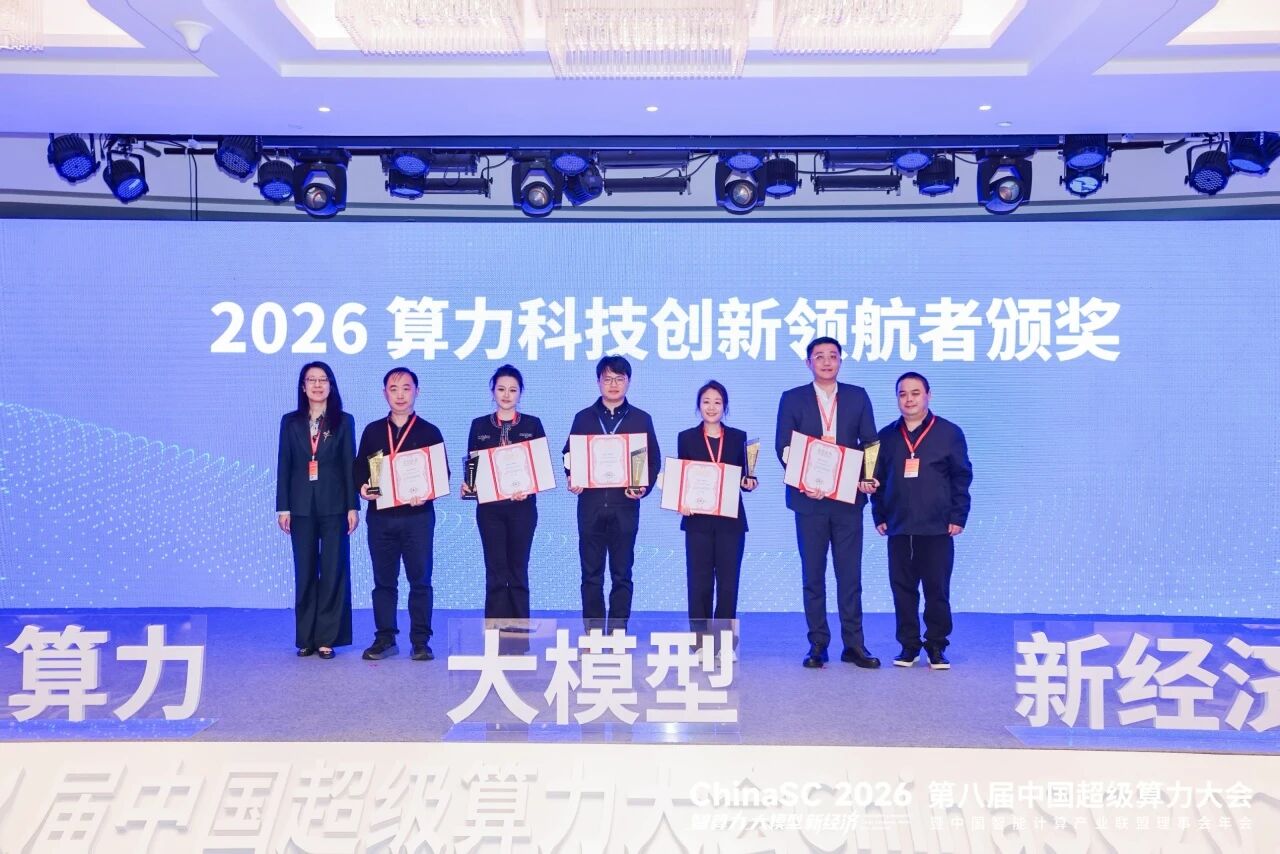
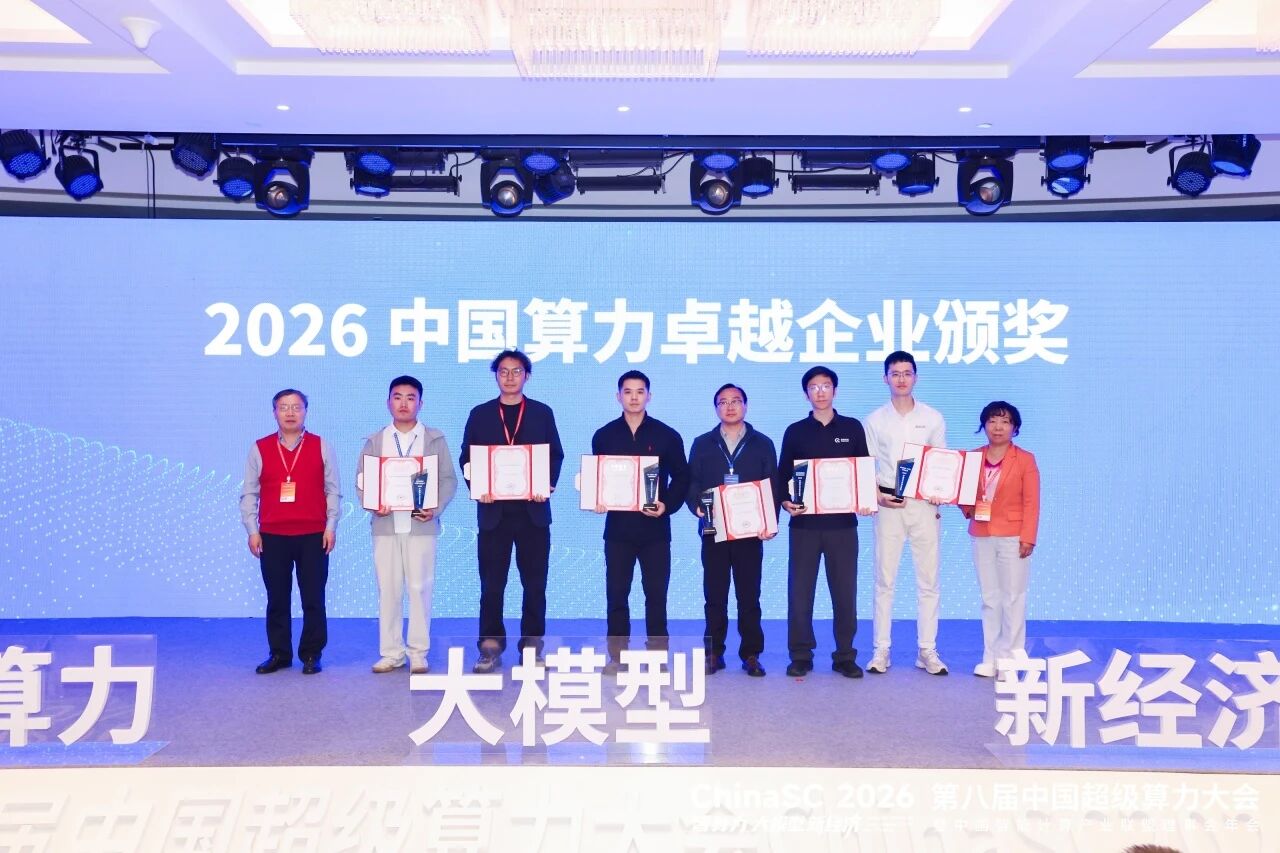
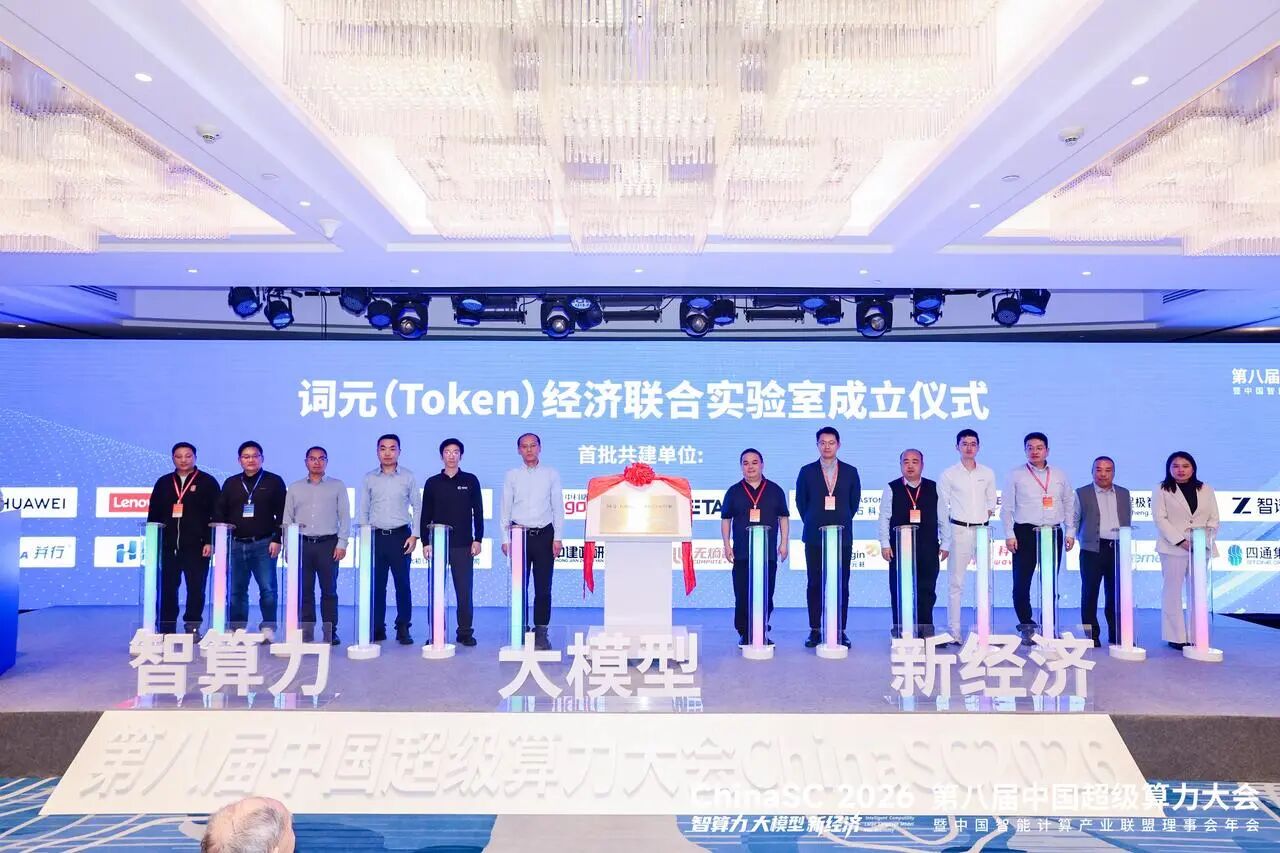
作为国内领先的独立第三方全栈算力技术服务商,刚刚成立满五年的是石科技在此次大会上亦收获颇丰,不仅公司创始人兼董事长闫博文荣获“2026 算力科技创新领航者”、是石科技荣膺“2026 中国算力卓越企业奖”,词元经济产业联合实验室的参与共建更彰显了是石科技从技术提供者到生态共建者的角色拓展。
此外,本次大会期间,是石科技最重磅消息当属由研发总监范洋发布的“多模态模型服务”新产品。这不仅是一次多模态模型服务的产品更新,也是是石科技对AI视频生产化路径的一次系统回答:当生成能力逐步走向普及,真正决定技术价值的,将是速度、成本、质量与素材利用能否在同一生产系统中协同优化。
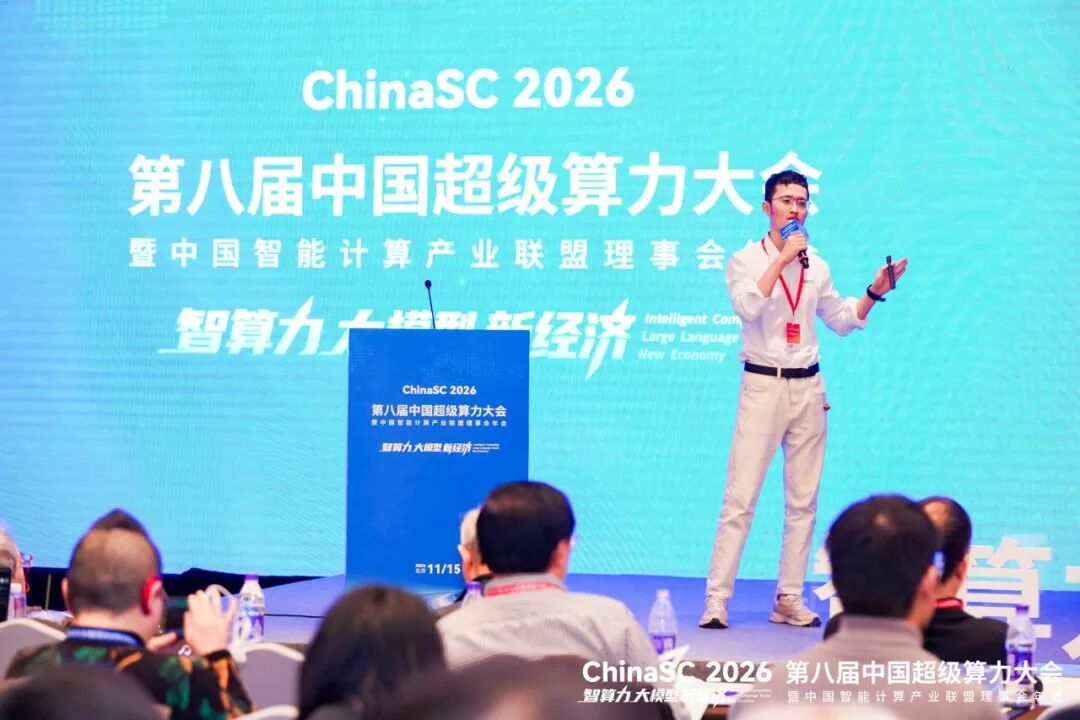
图丨是石科技研发总监范洋现场新品发布演讲
AI视频的下一场竞争,是生产系统的竞争
一次生成需要多久?批量生产是否划算?加速后画面还能保持质量吗?已有视频、音频能否用起来?
这四个来自创作与生产一线的问题,划出了AI视频从“能生成”走向“好生产”的真实边界。
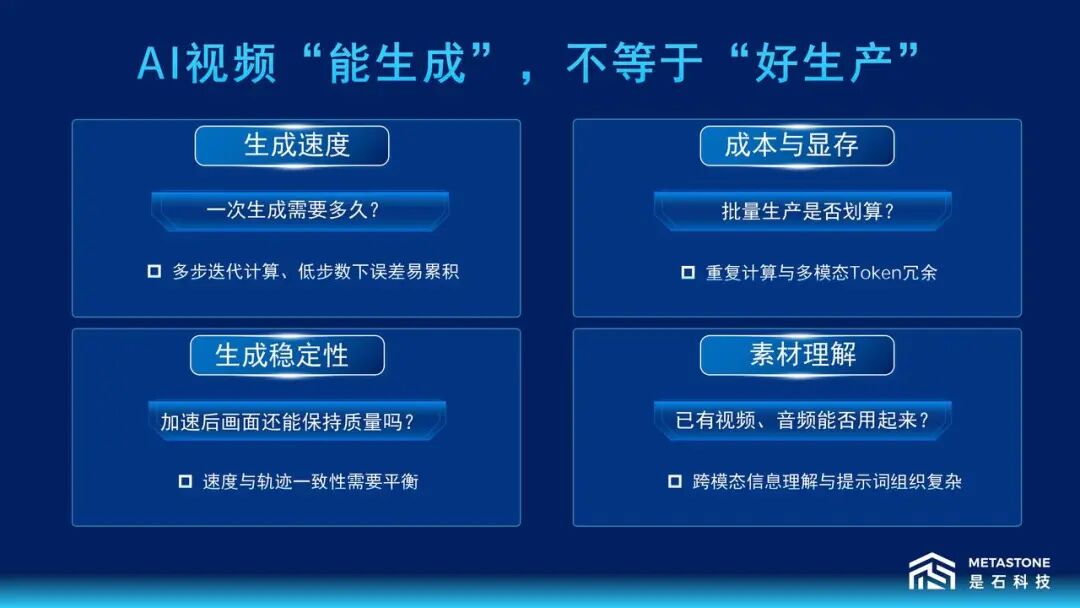
图丨是石科技及时响应创作者的视频生成“痛点”
对于视频生成来说,其通常涉及多步迭代计算。分辨率、时长与采样步数相互叠加,使计算量、显存占用和生成时延同步增长;进入低步数采样区间后,系统对计算效率更加敏感,特征预测偏差也更容易被放大。单纯减少计算步骤,可能赢得速度,却付出画面闪烁、主体漂移或运动失真的代价。
当生成任务由单次试验转向批量生产,成本问题进一步显现。重复计算、多模态Token冗余以及中间特征与缓存状态占用,会持续消耗硬件资源。此时,单位内容成本不取决于某一次模型调用的价格,而取决于整条推理链路能够将多少算力转化为符合交付要求的有效内容。
素材理解则构成另一道门槛。已有视频和音频并非简单的输入文件,而是包含画面、声音、时序和语义关系的复合信息体。系统如果只能接收素材,却不能完整理解并保留跨模态上下文,创作者仍需投入大量时间进行人工拆解和提示词组织,既有素材也难以真正转化为可复用的生产资料。
因此,AI视频生产化并不是某一个模型的单点问题,而是一场覆盖生成、理解、部署与资源调用的系统效率竞争。
真正需要优化的,不是一个模型,
而是一条推理链路
为了适配多数多模态模型,此次,是石科技打造了一套旨在让视频的生成和理解变得更高效的多模态模型推理服务架构。
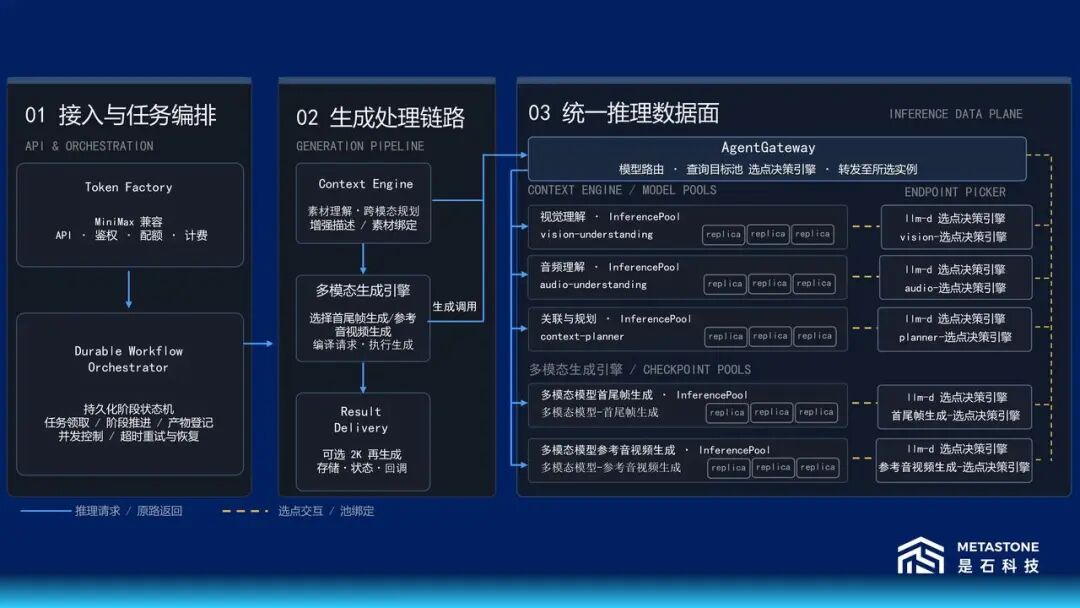
图丨是石科技多模态模型推理服务架构
该架构可被理解为一套分层体系:先是接入与任务编排,然后经由生成处理链路,最后在统一推理数据面由AgentGateway中的模型路由和选点决策引擎执行查询目标池及转发至所选实例等动作。
整套方案的工程价值不在于替换模型,而在于通过“算模协同、通算重构”,将算法层的加速策略转化为可部署、可调度、可持续运行的推理服务能力。
低步数生成,不能只在采样步数上做“减法”
在常规的多模态生成中,整计算常常会因为多步迭代而开销暴涨,因此是石科技将加速方案聚焦于20步/50步采样区间。而步数越少,相邻步骤之间的特征偏移越容易被后续计算放大。
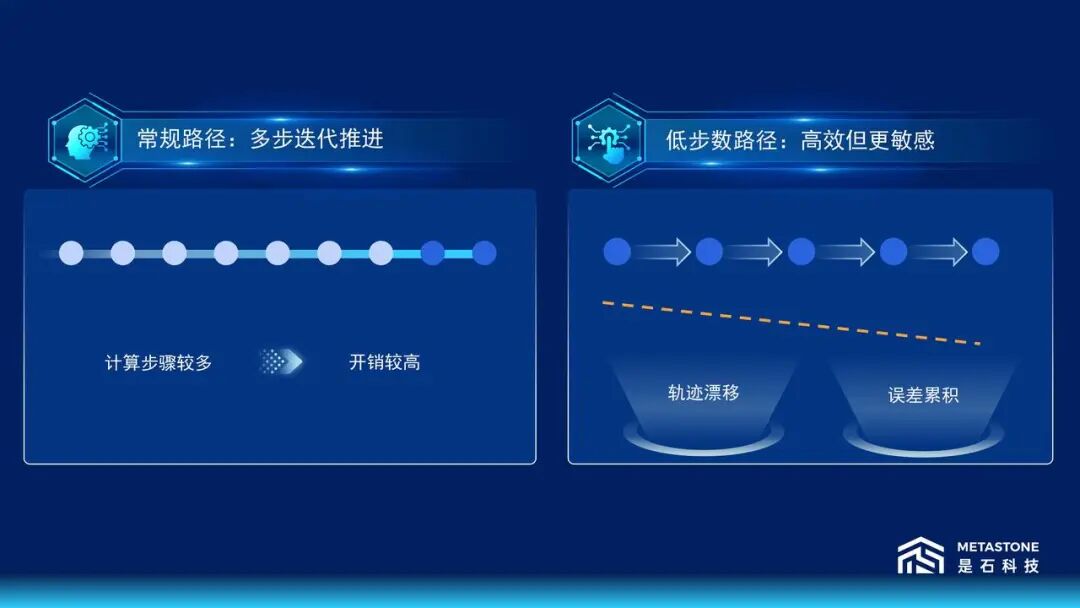
图丨是石科技在压缩采样步数的同时维持生成质量
为了解决这对矛盾,实现压缩采样步数的“鱼”与维持生成质量的“熊掌”二者兼得的理想目标,是石科技的方案将“基于历史缓存残差、自适应调制预测系数、保持特征轨迹一致”组合为一种风险感知缓存复用机制:低风险阶段复用缓存继续生成,高风险阶段及时刷新,并利用真实计算结果持续修正后续判断。
这意味着,系统并非机械照抄历史特征,而是根据残差变化动态决定复用与校正方式。其优化效果方向,是减少重复前向计算、降低端到端时延,同时抑制低步数生成中的误差累积,使“更快生成”与“稳定生成”不再相互对立。
算法提速之后,更要回答资源利用效率
算法层减少的计算量,只有转化为部署层的资源效率,才能真正形成批量生产能力。围绕“减少重复计算和显存开销”这一核心思路,是石科技的加速部署方案将缓存决策接入推理框架,然后又通过压缩、分块与调度协同实现更低显存开销,通过高请求并发与单机多实例的组合优化实现更高单机吞吐。
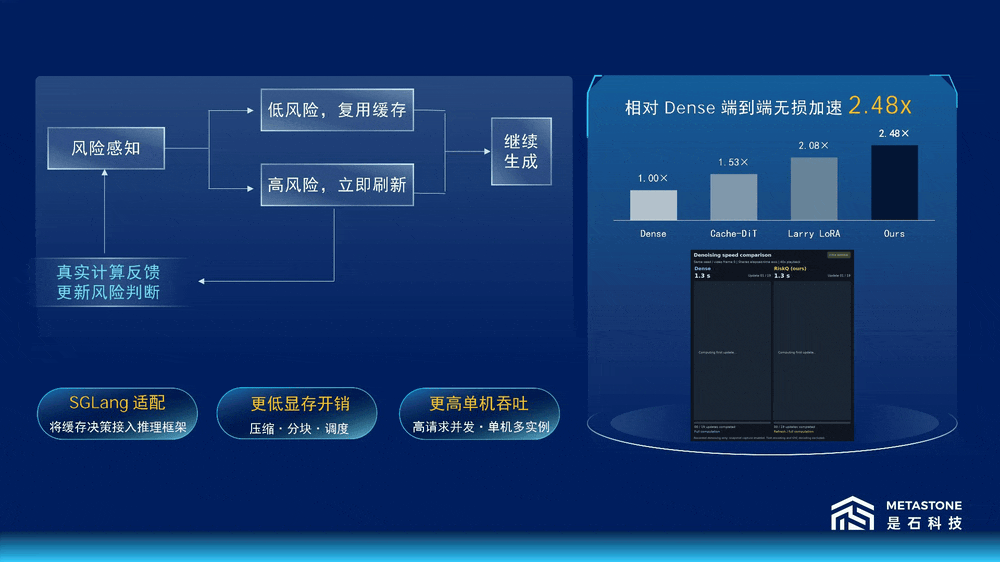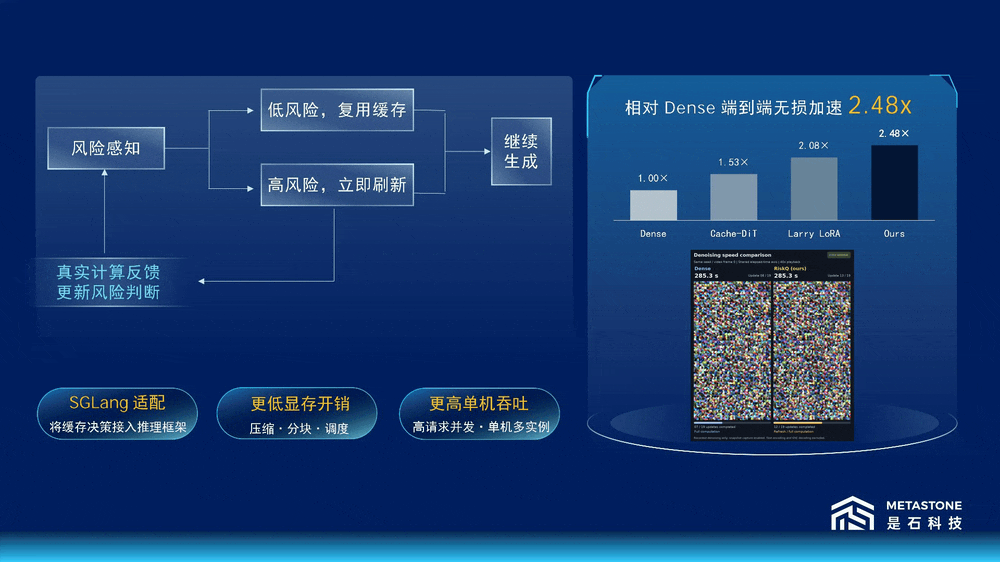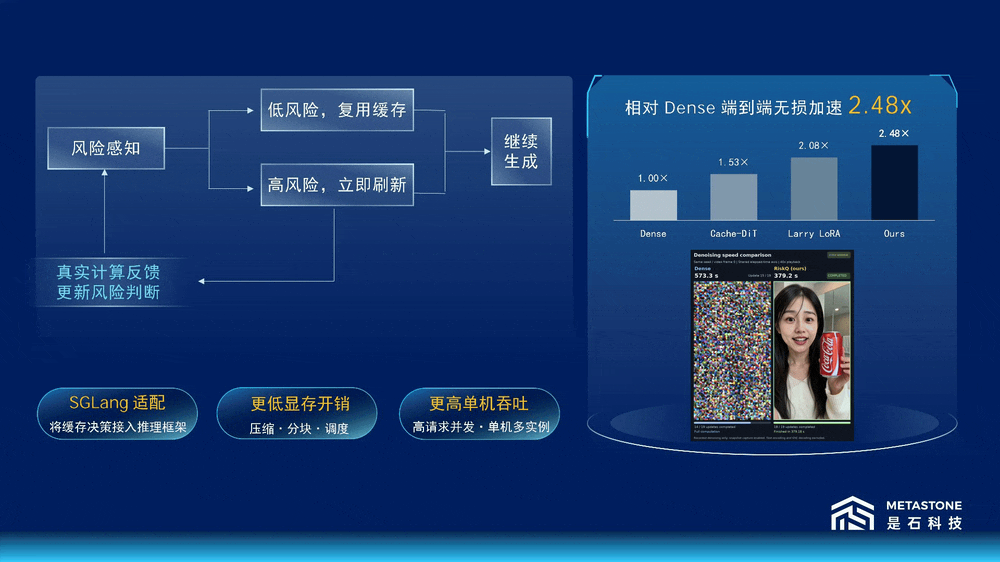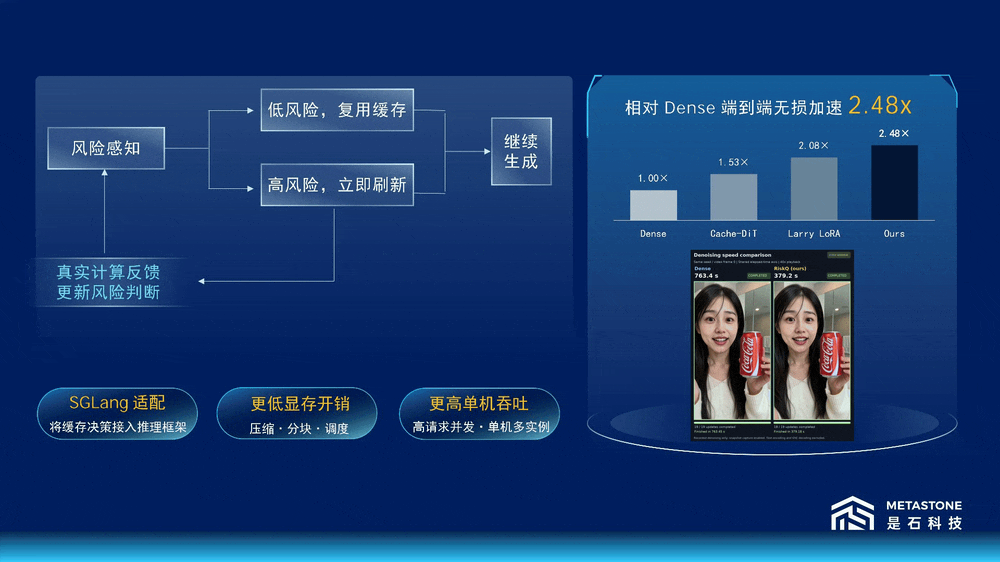
图丨该方案为内容生产团队带来更具经济性的单位内容成本
这一部署思路的优化效果方向,是降低单任务资源消耗,减少高负载条件下的显存浪费,并将单点加速进一步转化为整机有效吞吐。对于内容生产团队而言,其最终价值体现为更具经济性的单位内容成本;对于算力平台而言,则意味着让既有硬件释放更高的有效产出。
内部同口径测试显示,在标准生成视频任务中,是石科技方案相对Dense稠密基线实现2.48倍端到端提速,峰值显存与基线持平,画质评价为无损。
全模态理解,不能把所有Token等同对待
在全模态推理中,不同模态的信息密度、冗余程度及其与当前问题的相关性并不一致。采用统一比例或单一规则压缩Token,虽然能够缩短序列,也可能同步损失关键视觉、音频或文本信息。
是石科技提出基于模态自适应的免训练Token压缩方法,对应至已公开的OmniSelect技术路线。该成果由苏州大学、北京大学与是石科技联合完成,并入选NeurIPS 2026 Main Track。
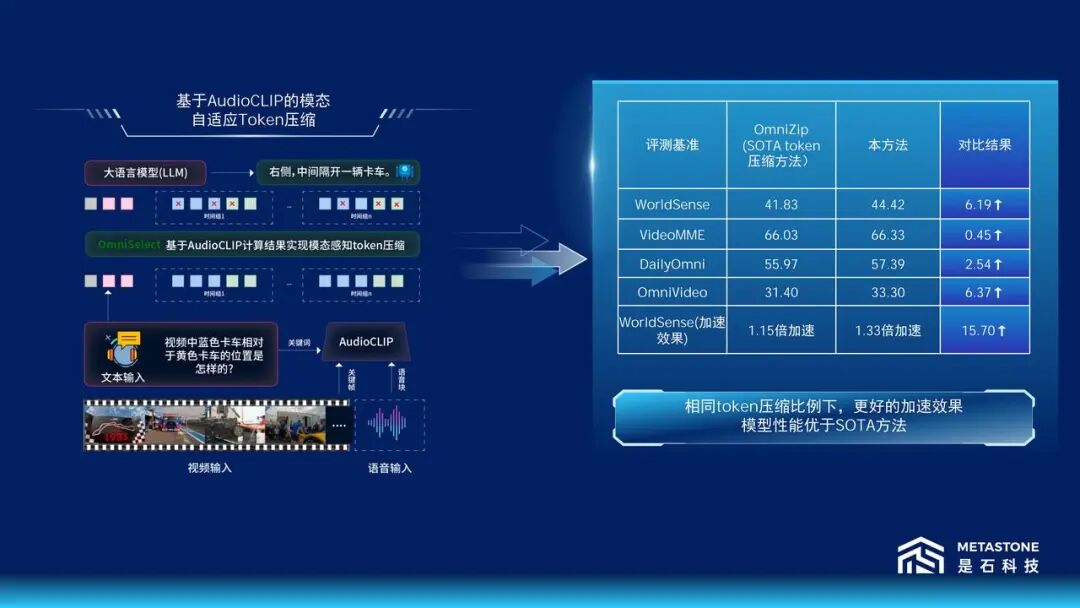
图丨Token压缩在提供更好加速效果同时保证模型性能
其技术路径主要包括三个环节:通过模态路由,根据问题与视觉、音频信息的跨模态相关性,将输入动态划分为音频主导、视频主导或均衡剪枝;通过时间组细粒度剪枝,在不同时间段内依据注意力分数与余弦相似度分配差异化压缩比例,使关键帧和关键音段得到更多保留;同时采用全程免训练方式,不更新模型权重。
这一方案解决的不是单一模态中的冗余问题,而是全模态场景下“模态相对重要性随问题变化”的动态取舍。其优化效果方向,是缩短有效推理序列、降低Prefill计算与显存开销,并在保持模型性能的同时提升理解效率。
论文实验口径下,OmniSelect实现1.19倍至1.33倍整体推理加速,GPU显存降低2.61GB至2.81GB,并保留全量输入94%至99%的精度。
让原始媒体成为可理解、可复用的生产上下文
针对已有视频、音频等素材难以高效进入生成流程的问题,是石科技提出了“1次感知+2次文本生成”的常规路径。其重点在于模态信息提取模型择优选择后,可以实现增强信息提取能力、指令遵循能力,减少重复输出的效果。
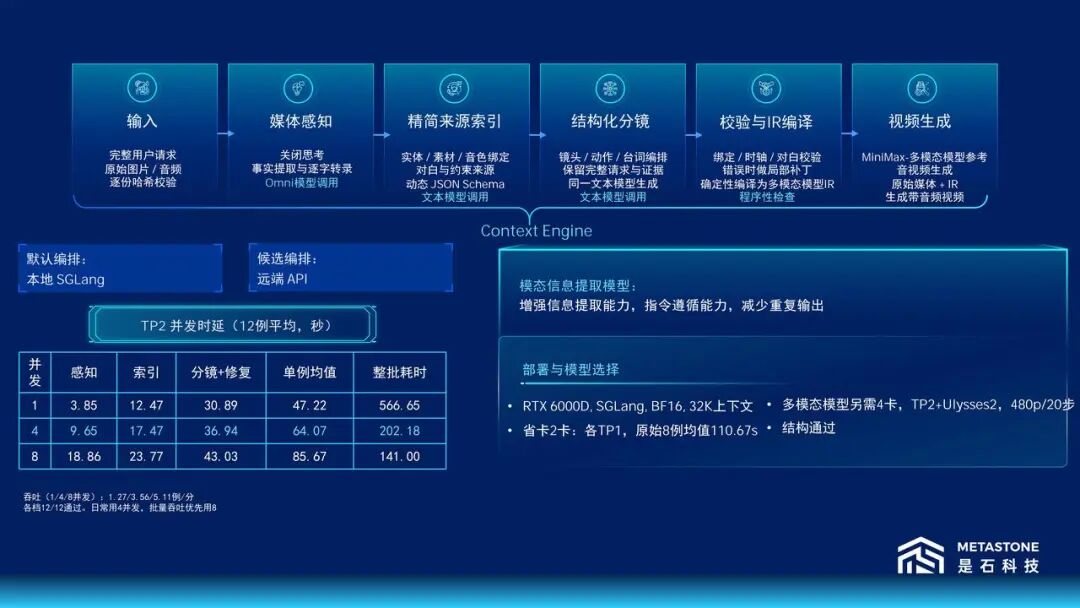
图丨是石科技基于全模态模型的Context Engine解决方案
由此,已有视频与音频不再只是需要人工拆解的静态文件,而能够转化为进入生成流程的结构化上下文。其优化效果方向,是减少素材理解与提示词组织成本,提高既有素材的复用效率和生成输入的可控性。
AI Infra的价值,最终要体现为内容生产力
从低步数生成的计算路径优化,到部署侧的资源效率提升;从全模态理解中的模态自适应Token压缩,到素材理解与信息提取增强,是石科技此次新品所呈现的,不是若干孤立技术指标,而是一套面向AI视频生产全流程的优化视角。
在这一体系中,速度不再只对应采样步数,成本不再只对应硬件投入,质量不再只对应单帧画面,素材理解也不再只是输入格式的扩展。它们被放入同一个生产系统之中,共同决定AI视频能否实现稳定、经济、可持续的交付。
此次新品发布,是是石科技AI Infra能力向多模态模型服务场景的一次深入延伸。面向持续增长的AI视频需求,是石科技将继续推动算法、系统与场景协同,让每一份算力更高效地转化为内容生产力,让AI视频真正从“能生成”走向“好生产”。